AI 기술 블로그
엔지니어링·제품·전략 관점에서 기술 리더와 연구자들의 심층 인사이트를 큐레이션합니다.
에이전트 AI의 병목 '디코드 지연', NVIDIA Groq 3 LPX는 어떻게 해결했나?
NVIDIA Groq 3 LPX 정식 생산으로 에이전트 AI를 위한 초고속 토큰 생성 인프라를 공개했다. Gemma 4 31B 기준 10만 토큰 컨텍스트에서 초당 3,400토큰을 출력하며 기존 플랫폼 대비 4배 빠른 성능을 기록했다. 실시간 상호작용이
클라우드 API 대신 로컬 SLM, 하드웨어 사양별 선택과 구축 가이드
1B~13B 규모의 소형 언어 모델(SLM)을 로컬에 구축해 데이터 유출 없이 사용할 수 있다. Ollama를 통해 GGUF 포맷 모델을 배포하며, 7B 모델 기준 4비트 양자화 시 약 8GB의 메모리가 필요하다. 데이터 보안이 중요하거나 토큰 비용
데이터 분석부터 API 배포까지 4번의 프롬프트로 끝낸 Grok Build의 실무 워크플로
Grok 4.6 기반의 터미널 에이전트 Grok Build가 데이터 생성부터 클라우드 배포까지 전 과정을 자동화했다. 4회의 프롬프트로 데이터 정제, 모델 학습(Gradient Boosting R² 0.934), FastAPI 배포를 완수했다. 터미널
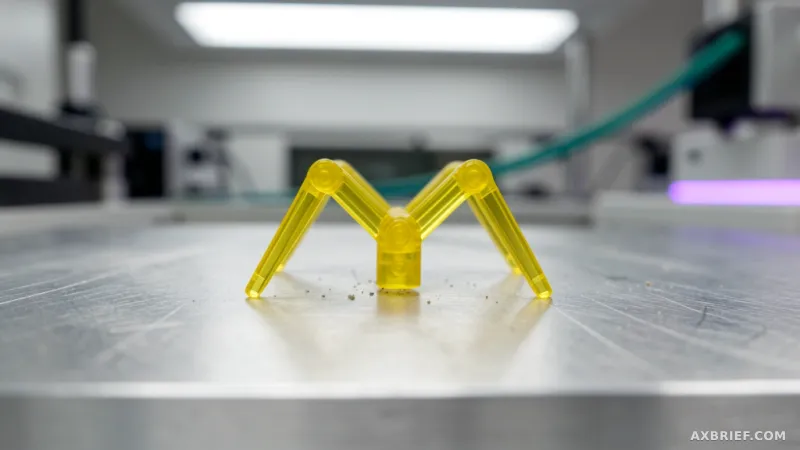
소리 진동을 추진력으로 바꾸는 150마이크로그램 초소형 로봇 구현
EPFL MICROBS 연구팀이 소리 에너지를 추진력으로 변환하는 중공 구조 로봇을 공개했다. 헬름홀츠 공명을 이용해 모터 없이 150마이크로그램 비행체를 띄우고 13,000RPM의 회전력을 만들었다. 전원 장치 없이 무선으로 구동되는 초소형 액추에이
평균 정확도 대신 '신뢰 보증'을 학습하는 파운데이션 월드 모델의 구조
환경 변화 속에서도 로봇의 행동 신뢰성을 유지하는 파운데이션 월드 모델 연구 방향을 제시한다. 강화학습의 유연성과 정형 기법의 검증력을 결합해 모델의 신뢰 범위를 정량적으로 측정하고 업데이트한다. 물리 AI 실무자는 모델의 평균 예측 오차율보다 특정
Amazon Bedrock RAG 비용 33% 절감하는 쿼리 인식 압축 구현법
RAG의 입력 토큰 비용을 줄이기 위해 소형 모델로 컨텍스트를 먼저 압축하는 패턴을 공개했다. Claude Haiku를 활용해 토큰 수를 최대 10.1배 줄였으며, 비용은 최대 36% 절감하고 환각률은 51%에서 38%로 낮췄다. 대규모 RAG 운영
AI 에이전트가 바꾼 5개 산업의 '실행' 워크플로
AI가 단순 답변을 넘어 계획과 실행을 스스로 수행하는 에이전트 시대로 전환됐다. 물류, 개발, 고객 서비스 등 5개 분야에서 루틴한 실행 단계를 자동화해 생산성을 높였다. 실무자는 단순 실행에서 벗어나 감독과 전략적 결정 역할로 전환하는 경로를 확인
Muse Glimmer 로컬 구동, 초당 127토큰 속도로 구현하는 자율 코딩 환경
Muse Glimmer를 llama.cpp와 DFlash로 구동해 로컬 자율 코딩 환경을 구축했다. 추측 디코딩 적용 시 최대 127 tokens/sec의 속도로 FastAPI 프로젝트를 2분 만에 완성했다. RTX 3090 이상의 GPU 사용자는 데
파나소닉 에비오닉스의 “진단 시간 단축”, 근거는 AWS 기반 멀티 에이전트 AI 도입
파나소닉 에비오닉스가 AWS 기반 멀티 에이전트 AI 시스템으로 항공기 IFEC 진단 공정을 자동화했다. LangGraph와 Claude를 활용해 수 시간 걸리던 수동 로그 분석 시간을 수 분 단위로 단축했다. 대규모 이기종 장비의 로그 정규화와 에이
수주 걸리던 데이터 온보딩을 수시간으로, AWS ADOP의 빌드 타임 가속 방식
AWS가 데이터 엔지니어링 온보딩 시간을 수주에서 수시간으로 단축하는 ADOP를 공개했다. 런타임 의존성 없이 빌드 타임에 결정론적 아티팩트를 생성해 배포하는 구조다. 데이터 플랫폼 책임자는 모델 호출 비용과 감사 가능성을 고려해 도입 시점을 결정해야
GPT-5.6의 '교차 리전 추론', Bedrock 가용량 제약 없이 처리량 높이는 법
Amazon Bedrock이 GPT-5.6 모델 3종과 교차 리전 추론(CRIS) 기능을 출시했다. 추론 프로필을 통해 25개 이상 리전의 자원을 통합 활용하며 100만 토큰 컨텍스트를 지원한다. 데이터 거주성 요구사항이 있는 실무자는 글로벌 프로필
ASR 벤치마크 점수가 높을수록 위험한 이유, '벤치맥싱' 판별 기준은?
ASR 모델들이 실제 음성보다 벤치마크 정답지를 암기해 점수를 올리는 '벤치맥싱' 현상이 확인됐다. 정답지 오류 재현율 18~30%, 마스킹된 숫자 복구율 30~40% 등 상위 모델일수록 이 경향이 강했다. 실무자는 WER 수치만 믿지 말고 홀드아웃
API 없이 화면만 보고 조작하는 구글 딥마인드 SIMA의 범용 게임 에이전트 전략
구글 딥마인드가 화면 픽셀과 자연어 지시만으로 게임을 수행하는 범용 에이전트 SIMA를 공개했다. 기존의 점수 최적화 방식에서 벗어나 Gemini를 기반으로 API나 소스 코드 없이 키보드와 마우스로 조작한다. 게임 개발자는 스크립트 기반 NPC 대체
Amazon Bedrock 기반 FHIR API 보안, "정적 규칙" 대신 "행동 베이스라인"으로 탐지
Amazon Bedrock을 활용해 헬스케어 FHIR API의 지능형 보안 모니터링 체계를 구축했다. 비동기 아키텍처로 API 지연 없이 사용자 행동 기반의 이상 징후 탐지와 데이터 민감도 분류를 자동화한다. 실무자는 PHI 보호를 위한 Guardra
Amazon Bedrock AgentCore, 300개 앱 IaC 개발 시간을 '주 단위'에서 '분 단위'로 단축했다
Amazon Bedrock AgentCore 기반 멀티 에이전트 프레임워크가 300개 이상의 애플리케이션 클라우드 마이그레이션을 자동화했다. 인프라 코드(IaC) 개발 시간을 앱당 3~4주에서 분 단위로 단축했으며, MCP를 통해 도구와 에이전트를 연
데이터 이동 제로와 90% 비용 절감, AWS가 정의한 벡터 엔진 선택 기준
AWS가 데이터 이동 없이 기존 저장소에서 바로 벡터 검색을 수행하는 통합 솔루션을 공개했다. S3 벡터는 비용을 최대 90% 낮췄으며, OpenSearch는 GPU 가속으로 인덱싱 속도를 10배 높였다. 실무자는 지연 시간 100ms 기준과 데이터
Snowflake 데이터를 QuickSight 대시보드까지, 코딩 없이 연결하는 ML 워크플로우
Snowflake 데이터를 기반으로 ML 모델 구축부터 시각화까지 수행하는 노코드 워크플로우를 공개했다. SageMaker Canvas로 모델을 생성하고 S3를 통해 QuickSight 대시보드로 예측값을 전송하는 구조다. 데이터 사이언스 인력 없이
벤더 종속 없는 기업용 AI 에이전트 확장, 핵심은 '제어 평면' 분리
기업용 AI 에이전트 확장은 여러 모델과 프레임워크가 공존하는 '멀티 에브리싱' 환경으로 진화한다. 애플리케이션 하단의 제어 평면을 표준화하여 거버넌스와 유연성을 동시에 확보하는 구조가 핵심이다. ML 플랫폼 팀은 프레임워크 강제 표준화 대신 제어 평
자연어 정책을 Dogwood 코드로 바꾸는 Bedrock AgentCore의 자동화 도구
Amazon Bedrock AgentCore가 자연어 정책 문서를 Dogwood 정형 명세로 변환하는 Policy Authoring 기능을 공개했다. 시간 제약, 누적 합계, Bedrock Guardrails 연동 등 복잡한 거버넌스 규칙을 실시간으로
AI가 세금과 군대를 대체할 때, OpenAI가 분석하는 권력 구조의 변화
OpenAI가 AI로 인한 권력 집중 리스크를 연구하는 Strategic Futures 팀과 블로그를 공개했다. 자율 시스템과 데이터 센터 기반 수익 구조가 기존의 인간 협력 기반 권력 체계를 무너뜨릴 수 있다고 분석한다. AI 거버넌스 설계자와 정책
LFM2.5-DSpark, MacBook에서 140tok/s 구현한 추론 가속 방식
LFM2.5 모델에 DSpark 기반 추론 가속을 적용해 추론 속도를 최대 3.2배 높였다. 300M 규모의 초경량 드래프트 모델이 토큰을 먼저 생성하고 타겟 모델이 한 번에 검증해 메모리 병목을 해결했다. SGLang과 llama.cpp 사용자는 제
Stampli, OpenAI 도구로 제품 출시 기간을 수개월에서 6주로 단축
Stampli가 Codex와 ChatGPT Work를 도입해 신제품 Deep Finance의 시장 진입 기간을 6주로 줄였다. 제작 공수를 243시간에서 77시간으로 3.16배 단축하고 주간 콘텐츠 발행량을 10배 확대했다. 내부 데이터 소스를 AI
GeForce NOW, 파이어폭스 공식 지원으로 브라우저 게임 진입 장벽 낮췄다
GeForce NOW가 파이어폭스 브라우저를 공식 지원하며 앱 설치 없는 클라우드 게임 접근성을 확대했다. 최신 파이어폭스에서 1440p 해상도와 120fps 성능을 제공하며, 이번 주 Gallipoli 포함 12종의 신작이 추가됐다. 저사양 PC 사
Virgin Atlantic이 도입한 생성형 AI 마켓 모델의 실시간 가격 결정 체계
생성형 AI 기반 마켓 모델이 기업의 상업적 의사결정 자동화를 지원한다. 고해상도 수치 데이터를 학습한 딥러닝 모델이 수요와 경쟁 상황을 실시간 시뮬레이션한다. 실시간 가격 책정 및 재고 관리가 필요한 항공·물류 실무자는 정적 규칙 기반 시스템의 전환
"티켓 무덤"에서 지식을 캐는 법, S3 Vectors와 Claude 4.5 기반 KnowledgeForge
ITSM 티켓의 해결 방법을 자동 추출해 지식 베이스(KB)로 전환하는 KnowledgeForge를 공개했다. Claude 4.5와 S3 Vectors를 활용해 중복 제거, 품질 개선, RAG 기반 문서 생성을 자동화한다. 대규모 문서 처리 파이프라인
제미나이 1년 무료와 딥 리서치로 무장한 구글의 대학생 학습 생태계
구글이 대학생 대상 제미나이 AI 플랜 1년 무료 혜택과 학습 전용 도구들을 공개했다. 제미나이 옴니 이용권, 2배의 사용 한도, 딥 리서치 및 3D 시각화 도구가 제공된다. 교육용 AI 서비스 도입을 검토하는 실무자는 제공 범위와 요금제 할인율을 확
수동 입력 90% 줄이는 AWS 서버리스 IDP와 Quick Automate 조합
GAIIC IDP Accelerator와 Quick Automate를 결합해 문서 분류부터 데이터 전송까지 전 과정을 자동화한다. 서버리스 구조로 인프라 관리 없이 처리량에 따라 비용을 지불하며, 수동 입력 90% 감소와 오류율 30% 개선 효과를 낸
2분당 40건의 요청을 처리하는 Fanatics의 멀티 에이전트 AI 고객지원 구조
Fanatics Betting and Gaming이 AWS 기반 멀티 에이전트 시스템을 도입해 복잡한 스포츠 베팅 고객 문의를 자동화했다. Amazon Bedrock과 MCP(Model Context Protocol)를 활용해 주별 규제와 계정 정보를
Bedrock AgentCore, 런타임 필터로 웹 검색 도메인과 날짜 제어한다
Bedrock AgentCore가 웹 검색 결과의 도메인과 발행 날짜를 요청 단위로 제어하는 런타임 필터링을 공개했다. 관리자 정책과 런타임 필터를 교집합(Include)과 합집합(Exclude) 방식으로 결합해 서버 측에서 강제한다. 데이터 거버넌스
데이터 저장 없이 악성 패턴만 잡아내는 OpenAI의 Private Safety Processing 공개
OpenAI가 ZDR(데이터 무저장) 환경에서도 다중 상호작용의 위험 패턴을 감지하는 Private Safety Processing을 공개했다. 고객 제어 키 기반 암호화와 자동화된 신호 탐지로, OpenAI 직원이 실제 데이터에 접근하지 않고도 안전