챗봇의 '수다'가 아닌 에이전트의 '결정'이 필요한 이유
지금까지의 생성형 AI는 무언가를 만들어내는 '창작'에 집중해 왔다. 하지만 기업의 실무 현장에서 필요한 것은 유려한 문장이 아니라 명확한 '예' 혹은 '아니오', 혹은 정해진 카테고리 중 하나를 선택하는 단호한 판단이다. 길게 이어지는 챗봇의 답변은 때로 불필요한 비용을 발생시키며, LLM 특유의 환각 현상은 기업용 자동화 파이프라인에서 치명적인 병목 구간이 된다. 추론 속도가 곧 운영 비용과 직결되는 환경에서, 이제는 생성(Generation)이 아닌 분류(Classification)로의 패러다임 전환이 필요한 시점이다. 이러한 요구에 응답하듯 OpenAI는 "Today, we're introducing the Decisions API."라며 결정 엔진의 등장을 알렸다.
정해진 선택지 속에서 답을 찾는 Decisions API의 메커니즘
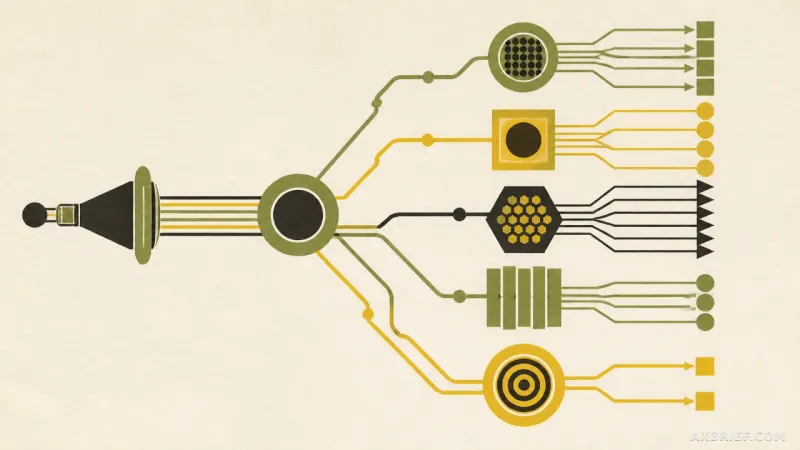
Decisions API의 핵심은 사용자가 정의한 답변 후보군 내에서만 최적의 답을 찾아내는 구조에 있다. 사용자가 텍스트나 이미지 입력을 제공하고, 이와 함께 질문과 가능한 답변 리스트를 정의하면 모델은 오직 그 선택지 중에서만 결과를 반환한다. 이는 복잡한 프롬프트 엔지니어링을 통해 모델의 답변 범위를 제한하려 했던 기존의 방식과는 완전히 궤를 달리한다. 입력값에 따라 즉각적인 분류와 결정이 수행되므로, 결과값의 예측 가능성이 극대화된다. 텍스트와 이미지라는 서로 다른 성격의 데이터를 동시에 처리할 수 있는 멀티모달 기능은 이 결정 엔진이 다룰 수 있는 데이터의 외연을 획기적으로 넓혔다.
GPT-6 Luna: 분류에 최적화된 전용 모델의 전략적 가치
이 모든 작동의 기반에는 GPT-6 Luna라는 전용 모델이 자리 잡고 있다. Luna는 모든 것을 잘하는 범용 모델이 아니라, '분류'라는 특정 목적에 최적화된 아키텍처를 가진다. 범용 모델이 방대한 가능성을 열어두고 다음 단어를 예측한다면, Luna는 주어진 선택지 사이의 확률적 우위를 빠르게 판단하는 데 집중한다. 이러한 특화 전략은 결정 속도와 정확도를 동시에 높이는 결과로 이어진다. 특히 멀티모달 입력을 효율적으로 처리하면서도 모델의 경량화와 성능 최적화 사이의 접점을 찾아냄으로써, 기업이 실제 서비스 파이프라인에 API를 통합했을 때 느끼는 지연 시간을 최소화했다.
시각 정보와 텍스트의 결합이 만드는 실무적 변화
텍스트와 이미지를 동시에 처리하는 능력은 실무 워크플로우의 라우팅 방식을 완전히 바꾼다. 예를 들어 제조 현장에서 제품의 사진(이미지)과 장비의 로그 데이터(텍스트)를 동시에 입력하면, Decisions API는 이를 분석해 '정상', '미세 불량', '심각 불량' 중 하나의 상태값을 즉각적으로 결정할 수 있다. 또한 복잡한 문서 이미지 내에서 특정 상태값을 찾아내어 다음 처리 단계로 넘기는 자동 분류 작업도 가능해진다. 2026년 10월 7일 Mark Kashef는 "Today, OpenAI released their long-awaited Decisions API"라고 언급하며 이 API가 가져올 기능적 성능에 주목했다. 시각 정보와 텍스트 로그의 결합 판단은 그동안 사람이 일일이 확인해야 했던 검수 과정을 자동화 엔진으로 대체하는 핵심 동력이 된다.
한국형 엔터프라이즈 AI 시장의 적용 시나리오
국내 산업 구조를 고려할 때 Decisions API의 활용도는 더욱 높다. 우선 복잡한 분류 체계를 가진 고객 서비스(CS) 영역에서 유입되는 문의를 API 기반으로 자동 분류하여 적절한 담당 부서로 배정하는 자동화가 가능하다. 특히 K-제조업의 강점인 품질 관리 분야에서는 시각 기반의 불량 판정 시스템을 고도화하는 데 즉각 투입될 수 있다. 정형 데이터와 비정형 데이터가 섞여 있는 전처리 단계에서 AI가 빠르게 데이터를 분류해 줌으로써 전체 파이프라인의 효율을 높일 수 있으며, 기존의 딱딱한 룰 기반(Rule-based) 시스템을 유연한 AI 기반 결정 시스템으로 전환하는 가교 역할을 할 것으로 보인다.
선택지의 한계와 '판단'의 경계선
물론 결정 엔진으로서의 명확함은 동시에 제약이 되기도 한다. Decisions API는 사용자가 정의한 옵션 밖의 상황이 발생했을 때 이를 창의적으로 해결하거나 새로운 대안을 제시하지 못한다. 창의적 추론이 배제된 결정론적 결과값만을 반환하기 때문에, 결국 얼마나 정교하게 답변 후보군을 설계하느냐라는 '데이터 라벨링' 수준의 옵션 정의 능력이 성능을 좌우하게 된다. 기업은 모든 문제를 이 API로 풀려 하기보다, 빠른 결정이 필요한 단순 분류 구간과 깊은 사고가 필요한 추론 구간을 적절히 분배하는 전략적 설계가 필요하다.